Http — что это, как проверить код ответа сервера 200, 301, 302, 404 и 500, редиректы 301 и 302 в htaccess
Здравствуйте, уважаемые читатели блога KtoNaNovenkogo.ru. Чуть ранее мы успели с вами поговорить о зеркалах, дублях страниц и их удалении.
Давайте сегодня продолжим тему и посмотрим каким образом поисковые роботы взаимодействую с нашими сайтами, чтобы понять, на какие вещи нужно обязательно обращать внимание и, в случае обнаружения ошибок, обязательно исправлять.

Казалось бы, что язык Http запросов и ответов сервера (сервер — это ПО на хостинге) настолько далек от SEO, что тратить время на понимание его принципов будет чудовищным расточительством. Однако, это не так.
Многие вещи, не заметные при беглом взгляде через браузер, могут оказывать колоссальное влияние на продвижение вашего сайта (вплоть до его полного выпадания из индекса). Увидеть все эти недочеты можно, только поняв, где и что именно нужно смотреть.
Что такое http и где посмотреть ответ сервера
HTTP (англ. HyperText Transfer Protocol — «протокол передачи гипертекста») — протокол прикладного уровня передачи данных, изначально — в виде гипертекстовых документов в формате HTML, в настоящее время используется для передачи произвольных данных.
Итак, при запросе браузером пользователя какой-либо страницы вашего сайта вместе с Html кодом этой вебстраницы, обозревателю будет передан и так называемый Http заголовок с ответом хоста, в котором помимо прочей информации будет указан код. Он представляет из себя трехзначное число (наиболее часто встречаются варианты 200, 301, 302, 404), которое обозначает ситуацию, сложившуюся на хосте при обработке запроса браузера.
Что такое HTTP? Это протокол, по которому осуществляется обмен данными между вебсервером, на котором расположен интересующий вас сайт, и вашим браузером. Расшифровывается аббревиатура как Hypertext Transfer Protocol. Браузер пользователя обращается к серверу с запросом какого-либо документа и получает соответствующий ответ.
Если ответ на http запрос приходит положительный (200 OK), то браузер начинает загрузку нужного ему файла. Если отрицательный, то информирует об этом пользователя. Имеется еще и шифрованный протокол SHTTP, но сути дела это не меняет.
Например, при успешной загрузке страницы, в браузер будет передан Http заголовок с кодом 200 OK (кроме цифр еще приводится и поясняющая надпись). В случае, если запрошенная страница на сервере найдена не будет, то браузер получит ответ 404 Not Found. Можете сами проверить ответ главной страницы своего сайта, например, на этом сервисе.
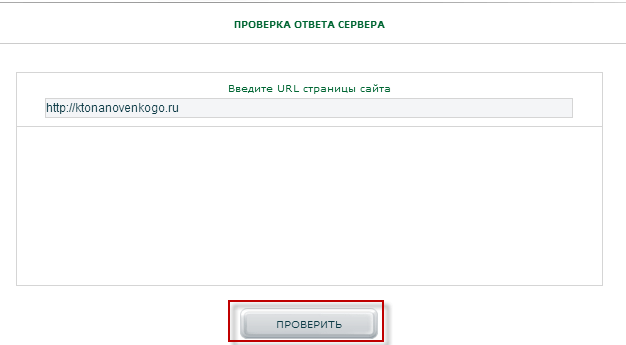
К примеру, введя туда заведомо несуществующий адрес страницы своего ресурса (для этого после доменного имени можно написать любую ахинею, например, https://ktonanovenkogo.ru/трали-вали), будет получен примерно такой Http заголовок:
HTTP/1.1 404 Not Found
Server: nginx/0.6.32
Date: Wed, 09 Mar 2011 14:52:43 GMT
Content-Type: text/html; charset=UTF-8
Transfer-Encoding: chunked
Connection: keep-alive
X-Powered-By: PHP/5.2.17
X-Pingback: https://ktonanovenkogo.ru/xmlrpc.php
Expires: Wed, 11 Jan 1984 05:00:00 GMT
Cache-Control: no-cache, must-revalidate, max-age=0
Pragma: no-cache
Last-Modified: Wed, 09 Mar 2011 14:52:43 GMT
Vary: Accept-Encoding
И это хорошо, ибо поисковые системы правильно обработают данный ответ сервера и не будут добавлять в индекс вашу несуществующую вебстраницу (404 страница для Joomla, 404 Not Found для Вордпресса).
Причем стоит учитывать, что несуществующие документы могут появиться как по вашей вине, так и из-за ошибки какого-либо доброжелателя, разместившего где-нибудь обратную ссылку на ваш сайт с ошибкой. Посмотреть те несуществующие документы (фактически битые ссылки), которые имеются на вашем ресурсе, вы можете в Яндекс Вебмастере или панели Google, как это было описано в статье Проверка битых ссылок.
Гораздо хуже будет, если несуществующий документ не будет выдавать в ответ 404, ибо в этом случае на вашем сайте по разным адресам (URL) несуществующих страниц (а их может быть сколь угодно много) будет выдаваться одна и так же вебстраница ошибки 404. На лицо будет откровенное дублирование контента, которое может повлечь за собой санкции со стороны поисковиков. А оно вам надо — на ровном месте наступать на грабли.
В принципе, еще хуже ситуация может сложиться, если вместо того, чтобы создать отдельную вебстраницу 404 для своего ресурса, вы настроили переброс посетителей на главную, в случае отсутствия запрашиваемого документа на сервере. Поисковые системы, не получив кода 404, вынуждены будут проиндексировать все эти не найденные страницы, а фактически содержимое главной.
Получится совсем неприятная картина — главная будет доступна сразу по неограниченному множеству адресов, ибо при запросе или переходе по битой ссылке будет открываться все время она. Выпадение из индекса главной из-за дублирования контента может нанести очень существенный урон всему продвижению сайта, ибо она, как правило, имеет наибольший статический вес и именно на нее будет приходиться львиная доля всех обратных внешних ссылок.
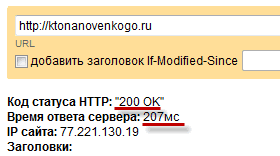
Обязательно проверьте коды ответа хотя бы у некоторых вебстраниц вашего ресурса, и особенно проверьте правильность цифр, выдаваемых в ответ на запрос несуществующего документа (введите что-то типа http://vash-domen.ru/jhguytrhkfkfijd). Для этой цели можно воспользоваться приведенным выше онлайн сервисом или же рядом других, способных показать все это:
Чтобы быть абсолютно уверенным в том, что поисковики правильно интерпретируют коды ответа вашего хоста, можете воспользоваться инструментом Яндекса Проверка ответа сервера, который, правда, будет вам доступен только после регистрации в Вебмастере, но добавиться туда, так же как и в панель Гугла, нужно будет в любом случае.
Все возможные варианты кодов ответа сервера
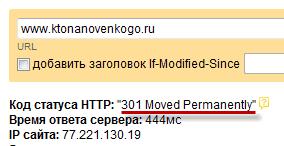
Обращу ваше внимание еще и на ответ сервера 301, который появляется в случае использования редиректа (перенаправление навсегда). Дело в том, что поисковые системы рекомендуют использовать 301 редирект в случае изменения адреса (URL) страницы сайта (он будет перебрасывать посетителя со старого Урла на новый) или, например, при склейке зеркал сайта с WWW или без WWW, как это было описано тут.
Если вы использовали 301 редирект, то можете проверить правильность Http ответа при обращении к склеенным Урлам. Например, при запросе www.ktonanovenkogo.ru сервер дает правильный ответ 301 Moved Permanently:
Вспомнил, что по поводу 404 ошибки я слышал довольно интересную историю. Вебмастер или оптимизатор, ведущий раскрутку определенного проекта, получил отставку и был этим сильно раздосадован. Причем, настолько сильно, что решился на то, чтобы подложить бывшему работодателю большую и жирную свинью.
Но сделал он все очень грамотно, ибо поначалу новые оптимизаторы, занимающиеся продвижением этого проекта, никак не могли понять, отчего позиции сайта резко просели. Как это реализовать на практике я не знаю, но тот вебмастер сделал так, что все страницы успешно открывались и отлично работали, но при этом в Http заголовке для всех них сервер давал ответ 404 Not Found.
Пустяк, вроде бы, абсолютно не влияющий на корректную работу ресурса, но напрочь убивающий все усилия по продвижению этого проекта. На этом примере, наверное, еще более наглядно можно увидеть важность проверки кодов ответа.
Правда в случае обнаружения неправильно формируемых кодов вам, скорее всего, придется обращаться за помощью к владельцу хостинга, в случае виртуального хоста, или же придется решать проблему самим, в случае выделенного сервера. Но главное, это вовремя диагностировать и локализовать проблему, воспользовавшись для этого соответствующими сервисами, некоторые из которых я упомянул чуть выше.
Вообще, все коды ответа сервера можно разделить на пять групп:
- 100-199 являются информационными, говорящими о том, что сервер обрабатывает запрос
- 200-299 означают, что запрашиваемые у сервера данные были успешно переданы (например, 200 — запрос был успешно выполнен и требуемые данные переданы)
300-399 означают переадресацию и необходимость выполнить дополнительные действия (например,301 — грубо говоря, документ изменил адрес навсегда; 302 — документ изменил адрес временно)
Код Ошибка Описание 300 Множественный выбор Затребованный URL обозначает более одного ресурса, и робот не смог однозначно определить, к какой странице URL относится (получен код
300 Multiple Choices).Исправьте заголовки или укажите ресурс правильно, и тогда робот сможет проиндексировать страницу.
301 Ресурс перемещен навсегда Документ уже не используется сервером, а ссылка перенаправляет на другую страницу (получен код
301 Moved Permanently).Так как пользователи не смогут увидеть подобные документы, показывать их в поиске не имеет смысла, и робот их не индексирует. Однако робот проиндексирует страницу, на которую установлено перенаправление, если она доступна.
302 Ресурс временно перемещен Запрошенный ресурс временно находится под другим адресом (получен код
302 Found).Так как пользователи не смогут увидеть подобные документы, показывать их в поиске не имеет смысла, и робот их не индексирует. Однако робот проиндексирует страницу, на которую установлено перенаправление, если она доступна.
303 Смотрите другой ресурс Запрошенный ресурс находится под другим адресом и его следует запрашивать, используя метод
GET(получен код303 See Other). Если вы хотите, чтобы указанная страница находилась в поиске, она должна отвечать кодом 200.304 Ресурс не изменялся Получен код
304 Not Modified. Если страница не изменилась с момента последнего обращения робота, рекомендуется выдавать этот код. Это ускорит индексирование и уменьшит трафик.305 Следует использовать прокси Доступ к затребованному ресурсу может осуществляться только через прокси-сервер, указанный в заголовке
Location(получен код305 Use Proxy).307 Временное перенаправление Затребованный ресурс был временно переведен на другой адрес, который необходимо прописать в
Location(получен код307 Temporary Redirect).- 400-499 означают, что запрос был сформирован не правильно и выполнен быть не может (например, 404 — документ по указанному адресу не найден на хосте)
Код Ошибка Описание 400 Неверный запрос/Bad Request Запрос не может быть понят сервером из-за некорректного синтаксиса.
401 Неавторизованный запрос/Unauthorized Для доступа к документу необходимо вводить пароль или быть зарегистрированным пользователем.
402 Необходима оплата за запрос/Payment Required Внутренняя ошибка или ошибка конфигурации сервера.
403 Доступ к ресурсу запрещен/Forbidden Доступ к документу запрещен. Если вы хотите, чтобы страница индексировалась, необходимо разрешить доступ к ней.
404 Ресурс не найден/Not Found Документ не существует. Если вы удалили какой-то раздел сайта, можно с помощью robots.txt запретить роботу обращаться к нему. Если такой страницы на сайте никогда не существовало, игнорируйте эту ошибку, возможно, кто-то поставил некорректную ссылку на ваш сайт.
405 Недопустимый метод/Method Not Allowed Метод, определенный в строке запроса (Request-Line), не дозволено применять для указанного ресурса, поэтому робот не смог его проиндексировать.
406 Неприемлемый запрос/Not Acceptable Нужный документ существует, но не в том формате (язык или кодировка не поддерживаются роботом).
407 Требуется идентификация прокси, файервола/Proxy Authentication Required Необходима регистрация на прокси-сервере.
408 Время запроса истекло/Request Timeout Сайт не передал полный запрос в течение установленного времени и робот разорвал соединение.
409 Конфликт/Conflict Запрос конфликтует с другим запросом или с конфигурацией сервера.
410 Ресурс недоступен/Gone Затребованный ресурс был окончательно удален с сайта.
411 Необходимо указать длину/Length Required Сервер отказывается принимать запрос без определенного заголовка Content-Length. Поправьте заголовки на своем сервере;— тогда в следующий раз робот сможет проиндексировать страницу.
412 Сбой при обработке предварительного условия/Precondition Failed При проверке на сервере одного или более полей заголовка запроса обнаружено несоответствие (сбой или ошибка при обработке предварительного условия).
413 Тело запроса превышает допустимый размер/Request Entity Too Large Сервер отказывается обрабатывать запрос потому, что размер запроса больше того, что может обработать сервер.
414 Недопустимая длина URI запроса/Request-URI Too Long Сервер отказывается обслуживать запрос, потому что запрашиваемый роботом URI (Request-URI) длиннее, чем сервер может интерпретировать.
415 Неподдерживаемый MIME тип/Unsupported Media Type Сервер отказывается обрабатывать запрос, потому что тело запроса имеет неподдерживаемый формат.
416 Диапазон не может быть обработан/Requested Range Not Satisfiable Сервер отказывается обрабатывать запрос, потому что значение поля Range в заголовке запроса указывает на недопустимый диапазон байтов.
417 Сбой при ожидании/Expectation Failed Сервер отказывается обрабатывать запрос, потому что значение поля
Expectв заголовке запроса не соответствует ожиданиям.422 Необрабатываемый элемент/Unprocessable Entity Сервер не в состоянии обработать один (или более) элемент запроса.
423 Заблокировано/Locked Сервер отказывается обработать запрос, так как один из требуемых ресурсов заблокирован.
424 Неверная зависимость/Failed Dependency Сервер отказывается обработать запрос, так как один из зависимых ресурсов заблокирован.
426 Требуется обновление/Upgrade Required Сервер запросил апгрейд соединения до SSL, но SSL не поддерживается клиентом.
429 Слишком много запросов/Too Many Requests Отправлено слишком много запросов за короткое время. Это может указывать, например, на попытку DDoS-атаки. Ответ может сопровождаться заголовком Retry-After, который указывает, через какое время можно повторить запрос. Яндекс не учитывает этот заголовок.
- 500-599 означают, что на сервере произошла ошибка и запрос выполнен быть не может. Посмотрите, например, что означает ошибка 502.
Код Ошибка Описание 500 Внутренняя ошибка сервера/Internal Server Error Сервер столкнулся с непредвиденным условием, которое не позволяет ему выполнить запрос.
501 Метод не поддерживается/Not Implemented Сервер не поддерживает функциональные возможности, требуемые для выполнения запроса. Этот ответ соответствует состоянию, когда сервер не распознает метод запроса и не способен обеспечить его для любого ресурса.
502 Ошибка шлюза/Bad Gateway Сервер, действуя в качестве шлюза или прокси-сервера, получил недопустимый ответ от следующего сервера в цепочке запросов, к которому обратился при попытке выполнить запрос.
503 Служба недоступна/Service Unavailable Возникла ошибка из-за временной перегрузки или отключения на техническое обслуживание сервера.
504 Время прохождения через межсетевой шлюз истекло/Gateway Timeout Сервер, при работе в качестве внешнего шлюза или прокси-сервера, своевременно не получил отклик от вышестоящего сервера, к которому он обратился, пытаясь выполнить запрос.
505 Версия НТТР не поддерживается/Version Not Supported Сервер не поддерживает или отказывается поддерживать версию HTTP-протокола, которая используется в сообщении запроса робота.
507 Недостаточно места/Not Extended Сервер не может обработать запрос из-за недостатка места на диске).
510 Отсутствуют расширения/Not Extended Сервер не может обработать запрос из-за того, что запрашиваемое расширение не поддерживается.
Более подробно посмотреть все возможные коды ответа в Http заголовке вы можете, например, в Википедии.
Http запросы — как поисковый робот общается с сервером
Теперь для продолжения разговора на тему, нам нужно будет посмотреть в стороны работы браузеров. Я уже довольно подробно писал, что такое браузер, но если говорить кратко, то это программа для просмотра Html страниц, загруженных из интернета. Но нас сейчас интересует конкретный вопрос: как происходит взаимодействие браузера и сайта?
Браузер (поисковый бот) и сервер общаются по протоколу Http
После того, как вы ввели Урл в адресную строку браузера (или, что то же самое, перешли по ссылке, или открыли закладку), он обращается к упомянутому выше DNS серверу (ближайшему), чтобы тот сообщил браузеру IP адрес, соответствующий введенному доменному имени сайта.
Правда, браузер сначала к файлу Hosts обращается и в свой ДНС кеш заглядывает, но если там ничего по данному домену не находит, то начинает ломиться в ближайший ДНС сервер (обычно он находится у вашего интернет-провайдера).
В DNS серверах хранятся таблицы соответствия доменов и соответствующих им IP адресов серверов (компьютеров, всегда подключенных к интернету), где физически размещаются файлы сайтов. Получив искомый IP адрес, браузер делает HTTP запрос к серверу с этим адресом.
Для передачи данных в таком запросе могут использоваться два метода: Get или Post. В обычных случаях используется Get, и если утрировать, то для нашего примера такой запрос может выглядеть так (указывается относительный URL адрес страницы — относительно корня сервера):
Get /papka/fail.html HTTP/1.1
Этот запрос уходит на IP адрес, полученный ранее от ДНС сервера. На сервере же установлено программное обеспечение (чаще всего Апач), которое, получив такой запрос, находит нужный файл по указанному относительному пути и отправляет его (в виде Html кода) обратно в браузер.
Браузер же, в свою очередь, этот Html код интерпретирует в веб-страницу с учетом CSS стилей, которые могли быть заданы как в самом Html коде, так и во внешнем файле стилей, который тоже будет подгружен.
А как происходит взаимодействие поискового робота с сайтом? По сути, точно так же. Робот отправляет запрос на ДНС сервер и получив IP отправляет Get запрос с указанием относительного пути до нужного ему файлика вебстраниц. Сервер запрос обрабатывает, находит файлик и отправляет ее в Html виде поисковому роботу.
Т.е. отличий фактически нет, ибо поисковый робот — это тот же самый браузер, у которого за ненадобностью отсутствует графический интерфейс (Html страницы он просто загружает, но не открывает). Кроме этого, бот не выполняет Джава-скрипты и не загружает картинки (их индексацией занимается специальных бот). Но это уже детали.
Следовательно, разобравшись в методах общения браузера с сервером, мы поймем, как поисковый робот общается с нашим сайтом и каки