Файл robots.txt и мета-тег robots — настройка индексации сайта Яндексом и Гуглом, правильный роботс и его проверка
При самостоятельном продвижении и раскрутке сайта важно не только создание уникального контента или подбор запросов в статистике Яндекса, но и так же следует уделять должное внимание такому показателю, как индексация ресурса поисковиками, ибо от этого тоже зависит весь дальнейший успех продвижения.
У нас с вами имеются в распоряжении два набора инструментов, с помощью которых мы можем управлять этим процессом как бы с двух сторон. Во-первых, существует такой важный инструмент как карта сайта (Sitemap xml). Она говорит поисковикам о том, какие страницы сайта подлежат индексации и как давно они обновлялись.
А, во-вторых, это, конечно же, файл robots.txt и похожий на него по названию мета-тег роботс, которые помогают нам запретить индексирование на сайте того, что не содержит основного контента (исключить файлы движка, запретить индексацию дублей контента), и именно о них и пойдет речь в этой статье...
Индексация сайта
Упомянутые выше инструменты очень важны для успешного развития вашего проекта, и это вовсе не голословное утверждение. В статье про Sitemap xml (см. ссылку выше) я приводил в пример результаты очень важного исследования по наиболее частым техническим ошибкам начинающих вебмастеров, там на втором и третьем месте (после не уникального контента) находятся как раз отсутствие этих файлов роботс и сайтмап, либо их неправильное составление и использование.
Почему так важно управлять индексацией сайта
Надо очень четко понимать, что при использовании CMS (движка) не все содержимое сайта должно быть доступно роботам поисковых систем. Почему?
- Ну, хотя бы потому, что, потратив время на индексацию файлов движка вашего сайта (а их может быть тысячи), робот поисковика до основного контента сможет добраться только спустя много времени. Дело в том, что он не будет сидеть на вашем ресурсе до тех пор, пока его полностью не занесет в индекс. Есть лимиты на число страниц и исчерпав их он уйдет на другой сайт. Адьес.
- Если не прописать определенные правила поведения в роботсе для этих ботов, то в индекс поисковиков попадет множество страниц, не имеющих отношения к значимому содержимому ресурса, а также может произойти многократное дублирование контента (по разным ссылкам будет доступен один и тот же, либо сильно пересекающийся контент), что поисковики не любят.
Хорошим решением будет запрет всего лишнего в robots.txt (все буквы в названии должны быть в нижнем регистре — без заглавных букв). С его помощью мы сможем влиять на процесс индексации сайта Яндексом и Google. Представляет он из себя обычный текстовый файл, который вы сможете создать и в дальнейшем редактировать в любом текстовом редакторе (например, Notepad++).
Поисковый бот будет искать этот файл в корневом каталоге вашего ресурса и если не найдет, то будет загонять в индекс все, до чего сможет дотянуться. Поэтому после написания требуемого роботса, его нужно сохранить в корневую папку, например, с помощью Ftp клиента Filezilla так, чтобы он был доступен к примеру по такому адресу:
https://ktonanovenkogo.ru/robots.txt
Кстати, если вы хотите узнать как выглядит этот файл у того или иного проекта в сети, то достаточно будет дописать к Урлу его главной страницы окончание вида /robots.txt. Это может быть полезно для понимания того, что в нем должно быть.
Однако, при этом надо учитывать, что для разных движков этот файл будет выглядеть по-разному (папки движка, которые нужно запрещать индексировать, будут называться по-разному в разных CMS). Поэтому, если вы хотите определиться с лучшим вариантом роботса, допустим для Вордпресса, то и изучать нужно только блоги, построенные на этом движке (и желательно имеющие приличный поисковый трафик).
Как можно запретить индексацию отдельных частей сайта и контента?
Прежде чем углубляться в детали написания правильного файла robots.txt для вашего сайта, забегу чуть вперед и скажу, что это лишь один из способов запрета индексации тех или иных страниц или разделов вебсайта. Вообще их три:
- Роботс.тхт — самый высокоуровневый способ, ибо позволяет задать правила индексации для всего сайта целиком (как его отдельный страниц, так и целых каталогов). Он является полностью валидным методом, поддерживаемым всеми поисковиками и другими ботами живущими в сети. Но его директивы вовсе не являются обязательными для исполнения. Например, Гугл не шибко смотрит на запреты в robots.tx — для него авторитетнее одноименный мета-тег рассмотренный ниже.
- Мета-тег robots — имеет влияние только на страницу, где он прописан. В нем можно запретить индексацию и переход робота по находящимся в этом документе ссылкам (подробнее смотрите ниже). Он тоже является полностью валидным и поисковики будут стараться учитывать указанные в нем значения. Для Гугла, как я уже упоминал, этот метод имеет больший вес, чем файлик роботса в корне сайта.
- Тег Noindex и атрибут rel="nofollow" — самый низкоуровневый способ влияния на индексацию. Они позволяют закрыть от индексации отдельные фрагменты текста (noindex) и не учитывать вес передаваемый по ссылке. Они не валидны (их нет в стандартах). Как именно их учитывают поисковики и учитывают ли вообще — большой вопрос и предмет долгих споров (кто знает наверняка — тот молчит и пользуется).
Важно понимать, что даже «стандарт» (валидные директивы robots.txt и одноименного мета-тега) являются необязательным к исполнению. Если робот «вежливый», то он будет следовать заданным вами правилам. Но вряд ли вы сможете при помощи такого метода запретить доступ к части сайта роботам, ворующим у вас контент или сканирующим сайт по другим причинам.
Вообще, роботов (ботов, пауков, краулеров) существует множество. Какие-то из них индексируют контент (как например, боты поисковых систем или воришек). Есть боты проверяющие ссылки, обновления, зеркалирование, проверяющие микроразметку и т.д.
Большинство роботов хорошо спроектированы и не создают каких-либо проблем для владельцев сайтов. Но если бот написан дилетантом или «что-то пошло не так», то он может создавать существенную нагрузку на сайт, который он обходит. Кстати, пауки вовсе на заходят на сервер подобно вирусам — они просто запрашивают нужные им страницы удаленно (по сути это аналоги браузеров, но без функции просмотра страниц).
Robots.txt — директива user-agent и боты поисковых систем
Роботс.тхт имеет совсем не сложный синтаксис, который очень подробно описан, например, в хелпе яндекса и хелпе Гугла. Обычно в нем указывается, для какого поискового бота предназначены описанные ниже директивы: имя бота ('User-agent'), разрешающие ('Allow') и запрещающие ('Disallow'), а также еще активно используется 'Sitemap' для указания поисковикам, где именно находится файл карты.
Стандарт создавался довольно давно и что-то было добавлено уже позже. Есть директивы и правила оформления, которые будут понятны только роботами определенных поисковых систем. В рунете интерес представляют в основном только Яндекс и Гугл, а значит именно с их хелпами по составлению robots.txt следует ознакомиться особо детально (ссылки я привел в предыдущем абзаце).
Например, раньше для поисковой системы Яндекс было полезным указать, какое из зеркал вашего вебпроекта является главным в специальной директиве 'Host', которую понимает только этот поисковик (ну, еще и Майл.ру, ибо у них поиск от Яндекса). Правда, в начале 2018 Яндекс все же отменил Host и теперь ее функции как и у других поисковиков выполняет 301-редирект.
Если даже у вашего ресурса нет зеркал, то полезно будет указать, какой из вариантов написания является главным - с www или без него.
Теперь поговорим немного о синтаксисе этого файла. Директивы в robots.txt имеют следующий вид:
<поле>:<пробел><значение><пробел>
<поле>:<пробел><значение><пробел>
Правильный код должен содержать хотя бы одну директиву «Disallow» после каждой записи «User-agent». Пустой файл предполагает разрешение на индексирование всего сайта.
User-agent
Директива «User-agent» должна содержать название поискового бота. При помощи нее можно настроить правила поведения для каждого конкретного поисковика (например, создать запрет индексации отдельной папки только для Яндекса). Пример написания «User-agent», адресованной всем ботам зашедшим на ваш ресурс, выглядит так:
User-agent: *
Если вы хотите в «User-agent» задать определенные условия только для какого-то одного бота, например, Яндекса, то нужно написать так:
User-agent: Yandex
Название роботов поисковых систем и их роль в файле robots.txt
Бот каждой поисковой системы имеет своё название (например, для рамблера это StackRambler). Здесь я приведу список самых известных из них:
Google http://www.google.com Googlebot
Яндекс http://www.ya.ru 	 Yandex
Бинг http://www.bing.com/ 	 bingbot
У крупных поисковых систем иногда, кроме основных ботов, имеются также отдельные экземпляры для индексации блогов, новостей, изображений и т.д. Много информации по разновидностям ботов вы можете почерпнуть тут (для Google).
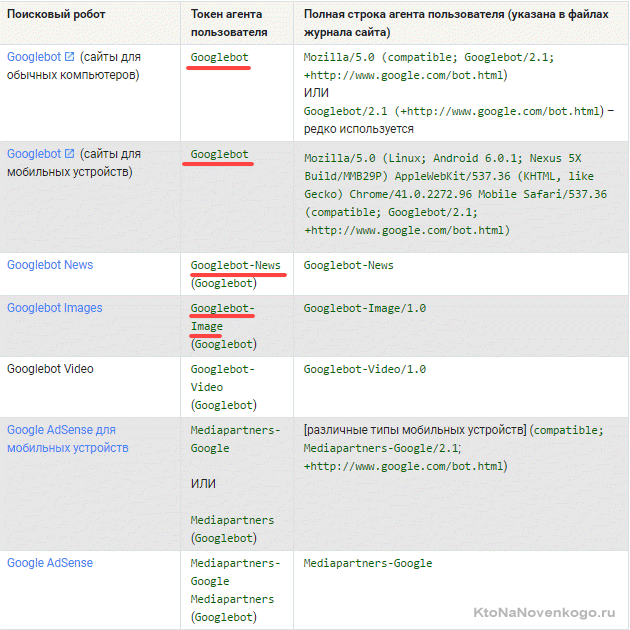
Как быть в этом случае? Если нужно написать правило запрета индексации, которое должны выполнить все типы роботов Гугла, то используйте название Googlebot и все остальные пауки этого поисковика тоже послушаются. Однако, можно запрет давать только, например, на индексацию картинок, указав в качестве User-agent бота Googlebot-Image. Сейчас это не очень понятно, но на примерах, я думаю, будет проще.
Примеры использования директив Disallow и Allow в роботс.тхт
Приведу несколько простых примеров использования директив с объяснением его действий.
- Приведенный ниже код разрешает всем ботам (на это указывает звездочка в User-agent) проводить индексацию всего содержимого без каких-либо исключений. Это задается пустой директивой Disallow.
User-agent: *
Disallow:
- Следующий код, напротив, полностью запрещает всем поисковикам добавлять в индекс страницы этого ресурса. Устанавливает это
Disallowс «/» в поле значения.User-agent: * Disallow: /
- В этом случае будет запрещаться всем ботам просматривать содержимое каталога /image/ (http://mysite.ru/image/ — абсолютный путь к этому каталогу)
User-agent: * Disallow: /image/
- Чтобы заблокировать один файл, достаточно будет прописать его абсолютный путь до него (читайте про абсолютные и относительные пути по ссылке):
User-agent: *
Disallow: /katalog1//katalog2/private_file.html
Забегая чуть вперед скажу, что проще использовать символ звездочки (*), чтобы не писать полный путь:
Disallow: /*private_file.html
- В приведенном ниже примере будут запрещены директория «image», а также все файлы и директории, начинающиеся с символов «image», т. е. файлы: «image.htm», «images.htm», каталоги: «image», «images1», «image34» и т. д.):
User-agent: *
Disallow: /image
Дело в том, что по умолчанию в конце записи подразумевается звездочка, которая заменяет любые символы, в том числе и их отсутствие. Читайте об этом ниже. - С помощью директивы Allow мы разрешаем доступ. Хорошо дополняет Disallow. Например, таким вот условием поисковому роботу Яндекса мы запрещаем выкачивать (индексировать) все, кроме вебстраниц, адрес которых начинается с /cgi-bin:
User-agent: Yandex
Allow: /cgi-bin
Disallow: /
Ну, или такой вот очевидный пример использования связки Allow и Disallow:
User-agent: *
Disallow: /catalog
Allow: /catalog/auto
- При описании путей для директив
Allow-Disallowможно использовать символы '*' и '$', задавая, таким образом, определенные логические выражения.- Символ '*'(звездочка) означает любую (в том числе пустую) последовательность символов. Следующий пример запрещает всем поисковикам индексацию файлов с расширение «.php»:
User-agent: *
Disallow: *.php$
- Зачем нужен на конце знак $ (доллара)? Дело в том, что по логике составления файла robots.txt, в конце каждой директивы как бы дописывается умолчательная звездочка (ее нет, но она как бы есть). Например мы пишем:
Disallow: /images
Подразумевая, что это то же самое, что:
Disallow: /images*
Т.е. это правило запрещает индексацию всех файлов (вебстраниц, картинок и других типов файлов) адрес которых начинается с /images, а дальше следует все что угодно (см. пример выше). Так вот, символ $ просто отменяет эту умолчательную (непроставляемую) звездочку на конце. Например:
Disallow: /images$
Запрещает только индексацию файла /images, но не /images.html или /images/primer.html. Ну, а в первом примере мы запретили индексацию только файлов оканчивающихся на .php (имеющих такое расширение), чтобы ничего лишнего не зацепить:
Disallow: *.php$
- Символ '*'(звездочка) означает любую (в том числе пустую) последовательность символов. Следующий пример запрещает всем поисковикам индексацию файлов с расширение «.php»:
- Во многих движках пользователи настраивают так называемые ЧПУ (человеко-понятные Урлы), в то время как Урлы, генерируемые системой, имеют знак вопроса '?' в адресе. Этим можно воспользоваться и написать такое правило в robots.txt:
User-agent: *
Disallow: /*?
Звездочка после вопросительного знака напрашивается, но она, как мы с вами выяснили чуть выше, уже подразумевается на конце. Таким образом мы запретим индексацию страниц поиска и прочих служебных страниц создаваемых движком, до которых может дотянуться поисковый робот. Лишним не будет, ибо знак вопроса чаще всего CMS используют как идентификатор сеанса, что может приводить к попаданию в индекс дублей страниц.
Директивы Sitemap и Host (для Яндекса) в Robots.txt
Во избежании возникновения неприятных проблем с зеркалами сайта, раньше рекомендовалось добавлять в robots.txt директиву Host, которая указывал боту Yandex на главное зеркало.
Однако, в начале 2018 год это было отменено и и теперь функции Host выполняет 301-редирект.
Директива Host — указывает главное зеркало сайта для Яндекса
Например, раньше, если вы еще не перешли на защищенный протокол, указывать в Host нужно было не полный Урл, а доменное имя (без http://, т.е. ktonanovenkogo.ru, а не https://ktonanovenkogo.ru). Если же уже перешли на https, то указывать нужно будет полный Урл (типа https://myhost.ru).
Сейчас переезд сайта после отказа от директивы Host очень сильно упростился, ибо теперь не нужно ждать пока произойдет склейка зеркал по директиве Host для Яндекса, а можно сразу после настройки Https на сайте делать постраничный редирект с Http на Https.
Напомню в качестве исторического экскурса, что по стандарту написания роботс.тхт за любой директивой User-agent должна сразу следовать хотя бы одна директива Disallow (пусть даже и пустая, ничего не запрещающая). Так же, наверное, имеется смысл прописывать Host для отдельного блока «User-agent: Yandex», а не для общего «User-agent: *», чтобы не сбивать с толку роботов других поисковиков, которые эту директиву не поддерживают:
User-agent: Yandex
Disallow:
Host: www.site.ru
либо
User-agent: Yandex
Disallow:
Host: site.ru
либо
User-agent: Yandex
Disallow:
Host: https://site.ru
либо
User-agent: Yandex
Disallow:
Host: https://www.site.ru
в зависимости от того, что для вас оптимальнее (с www или без), а так же в зависимости от протокола.
Указываем или скрываем путь до карты сайта sitemap.xml в файле robots
Директива Sitemap указывает на местоположение файла карты сайта (обычно он называется Sitemap.xml, но не всегда). В качестве параметра указывается путь к этому файлу, включая http:// (т.е. его Урл).Благодаря этому поисковый робот сможете без труда его найти. Например:
Sitemap: http://site.ru/sitemap.xml
Раньше файл карты сайта хранили в корне сайта, но сейчас многие его прячут внутри других директорий, чтобы ворам контента не давать удобный инструмент в руки. В этом случае путь до карты сайта лучше в роботс.тхт не указывать. Дело в том, что это можно с тем же успехом сделать через панели поисковых систем (Я.Вебмастер, Google.Вебмастер, панель Майл.ру), тем самым «не паля» его местонахождение.
Местоположение директивы Sitemap в файле robots.txt не регламентируется, ибо она не обязана относиться к какому-то юзер-агенту. Обычно ее прописывают в самом конце, либо вообще не прописывают по приведенным выше причинам.
Проверка robots.txt в Яндекс и Гугл вебмастере
Как я уже упоминал, разные поисковые системы некоторые директивы могут интерпритировать по разному. Поэтому имеет смысл проверять написанный вами файл роботс.тхт в панелях для вебмастеров обоих систем. Как проверять?
- Зайти в инструменты проверки Яндекса и Гугла.
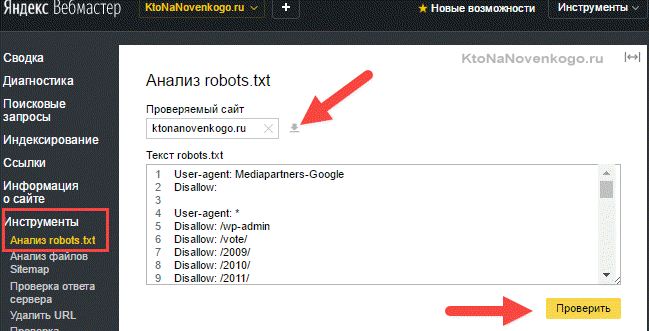
Убедиться, что в панель вебмастера загружена версия файла с внесенными вами изменениями. В Яндекс вебмастере загрузить измененный файл можно с помощью показанной на скриншоте иконки:
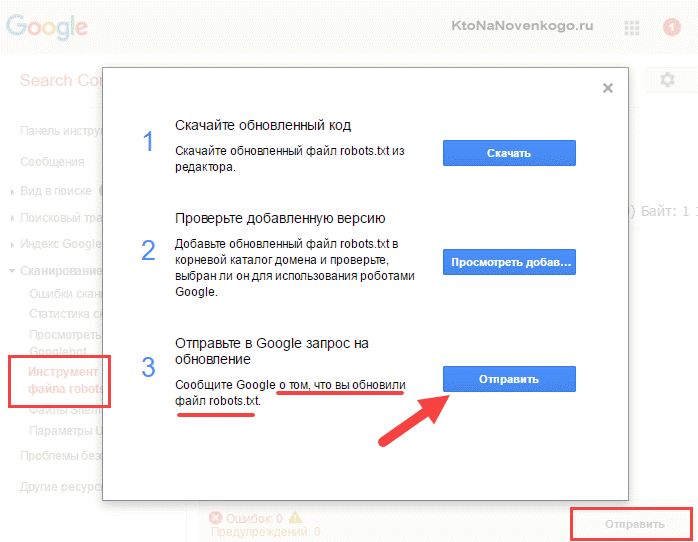
В Гугл Вебмастере нужно нажать кнопку «Отправить» (справа под списком директив роботса), а затем в открывшемся окне выбрать последний вариант нажатием опять же на кнопку «Отправить»:
- Набрать список адресов страниц своего сайта (по Урлу в строке), которые должны индексироваться, и вставить их скопом (в Яндексе) или по одному (в Гугле) в расположенную снизу форму. После чего нажать на кнопку «Проверить».
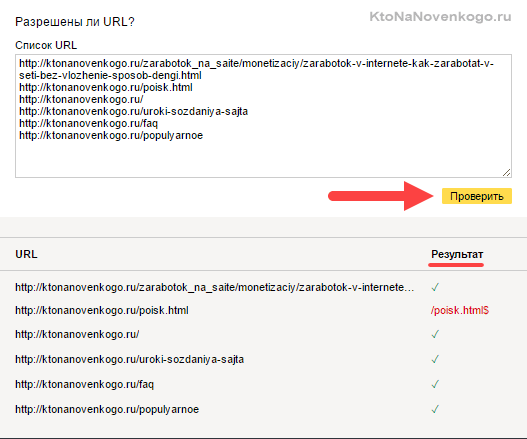
Если возникли нестыковки, то выяснить причины, внести изменения в robots.txt, загрузить обновленный файл в панель вебмастеров и повторить проверку. Все ОК?
Тогда составляйте список страниц, которые не должны индексироваться, и проводите их проверку. При необходимости вносите изменения и проверку повторяйте. Естественно, что проверять следует не все страницы сайта, а ярких представителей своего класса (страницы статей, рубрики, служебные страницы, файлы картинок, файлы шаблона, файлы движка и т.д.)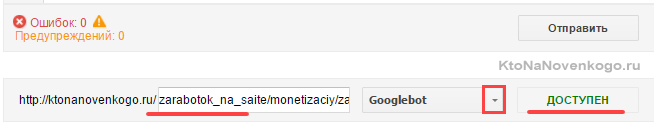
Причины ошибок выявляемых при проверке файла роботс.тхт
- Файл должен находиться в корне сайта, а не в какой-то папке (это не .htaccess, и его действия распространяются на весь сайт, а не на каталог, в котором его поместили), ибо поисковый робот его там искать не будет.
- Название и расширение файла robots.txt должно быть набрано в нижнем регистре (маленькими) латинскими буквами.
- В названии файла должна быть буква S на конце (не robot.txt, как многие пишут)
- Часто в User-agent вместо звездочки (означает, что этот блок robots.txt адресован всем ботам) оставляют пустое поле. Это не правильно и * в этом случае обязательна
User-agent: *
Disallow: /
- В одной директиве Disallow или Allow можно прописывать только одно условие на запрет индексации директории или файла. Так нельзя:
Disallow: /feed/ /tag/ /trackback/
Для каждого условия нужно добавить свое Disallow:
Disallow: /feed/
Disallow: /tag/
Disallow: /trackback/
- Довольно часто путают значения для директив и пишут:
User-agent: /
Disallow: Yandex
вместо
User-agent: Yandex
Disallow: /
- Порядок следования Disallow (Allow) не важен — главное, чтобы была четкая логическая цепь
- Пустая директива Disallow означает то же, что «Allow: /»
- Нет смысла прописывать директиву sitemap под каждым User-agent, если будете указывать путь до карты сайта (читайте об этом ниже), то делайте это один раз, например, в самом конце.
- Директиву Host лучше писать под отдельным «User-agent: Yandex», чтобы не смущать ботов ее не поддерживающих
Мета-тег Robots — помогает закрыть дубли контента при индексации сайта
Существует еще Ð